Tips Mengoptimalkan GPU untuk AI di 2026, Atur Memory hingga Batch Size agar Lebih Efisien
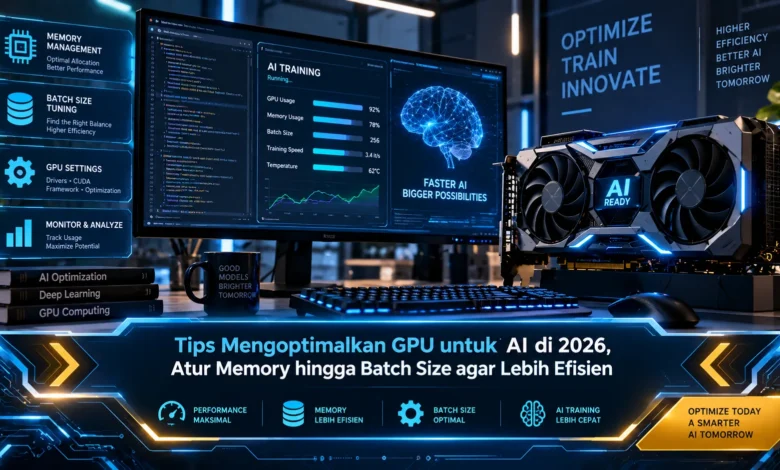
Penggunaan GPU untuk menjalankan workload AI pada 2026 semakin beragam, mulai dari inference model lokal, generative AI, hingga training dan fine tuning. Namun, GPU yang cepat belum tentu memberikan hasil optimal jika VRAM, batch size, precision, dan alokasi memory tidak dikonfigurasi dengan tepat. Dalam perkembangan TEKNOLOGI AI yang semakin intensif terhadap komputasi, memahami cara mengoptimalkan sumber daya GPU menjadi langkah penting agar performa tetap tinggi tanpa memboroskan kapasitas perangkat.
Kenali Kebutuhan GPU dan VRAM Sebelum Menjalankan AI
Tahap awal dalam mengoptimalkan GPU untuk AI adalah memahami kebutuhan model yang akan digunakan. Setiap model AI memiliki kebutuhan komputasi dan memory yang berbeda, sehingga konfigurasi yang cocok untuk satu model belum tentu ideal untuk model lainnya. Model dengan jumlah parameter tinggi umumnya membutuhkan VRAM lebih banyak dibandingkan model yang lebih ringan.
Selain ukuran model, jenis proses yang dijalankan juga perlu diperhatikan. Pelatihan model cenderung mengonsumsi memory lebih tinggi karena harus menyimpan berbagai data sementara selama komputasi, sementara inference dapat memiliki pola penggunaan memory yang berbeda. Dengan memahami perbedaan tersebut, konfigurasi GPU dapat disusun secara lebih efisien.
Manajemen VRAM Menjadi Kunci Optimasi GPU AI
Pengaturan kapasitas memori grafis merupakan faktor utama dalam menjaga performa workload AI. Memory GPU bukan sekadar tempat untuk memuat parameter model, namun turut dibutuhkan oleh data input, tensor sementara, cache, serta proses komputasi lainnya. Dengan demikian, menggunakan hampir seluruh memory hanya untuk model dapat membuat workload kekurangan ruang saat komputasi dimulai.
Salah satu strategi yang dapat diterapkan ialah tidak membiarkan penggunaan VRAM berada pada batas maksimum sejak awal. Pengguna juga dapat memantau konsumsi memory selama workload berjalan untuk mengidentifikasi operasi yang memberikan tekanan terbesar terhadap VRAM. Apabila software lain turut memakai akselerasi grafis, menghentikan proses tersebut dapat membantu membebaskan VRAM agar model memperoleh ruang komputasi yang lebih memadai.
Batch Size yang Tepat Membantu Menjaga Efisiensi
Ukuran batch memberikan dampak besar terhadap konsumsi VRAM dan throughput. Jumlah sampel yang semakin banyak dalam satu batch umumnya meningkatkan konsumsi memory GPU, meskipun pada kondisi tertentu dapat meningkatkan pemanfaatan GPU. Sementara itu, ukuran batch yang sangat rendah berpotensi membuat sebagian kemampuan komputasi GPU tidak terpakai.
Cara yang lebih praktis ialah menguji beberapa ukuran batch sembari memperhatikan konsumsi memory. Apabila konsumsi VRAM semakin mendekati kapasitas maksimum, pengaturan dapat diturunkan sedikit untuk menjaga margin memory. Jika batch kecil diperlukan karena keterbatasan VRAM, teknik gradient accumulation dapat digunakan untuk menggabungkan gradient dari beberapa proses sehingga kebutuhan memory per langkah tetap lebih rendah tanpa kehilangan manfaat akumulasi batch.
Gunakan Mixed Precision untuk Menghemat Memory
Precision menjadi faktor penting dalam mengatur efisiensi workload kecerdasan buatan. Menjalankan setiap komputasi menggunakan format numerik berpresisi tinggi dapat meningkatkan kebutuhan memory padahal workload tertentu dapat memanfaatkan precision yang lebih rendah. Karena itu, mixed precision dapat digunakan sebagai salah satu metode meningkatkan efisiensi komputasi.
Representasi numerik seperti FP16 maupun BF16 berpotensi menekan konsumsi VRAM dibandingkan menjalankan seluruh komputasi dalam FP32. Ketika kartu grafis memiliki dukungan komputasi yang sesuai, throughput dapat bertambah karena GPU mampu menjalankan komputasi dengan lebih efektif. Meski demikian, pengguna tetap perlu memastikan model dan framework mendukung precision yang digunakan agar optimasi tidak menimbulkan masalah numerik atau kestabilan.
Model AI Bisa Dibuat Lebih Ringan dengan Quantization
Teknik quantization merupakan pendekatan yang berguna apabila keterbatasan memory menghambat penggunaan model. Teknik ini mengurangi precision representasi parameter, yang kemudian dapat menekan konsumsi VRAM. Format 8 bit maupun 4 bit berpotensi membuat model yang sebelumnya terlalu berat menjadi lebih mudah dimuat.
Selain quantization, teknik checkpointing maupun offloading dapat digunakan sesuai dukungan software yang tersedia. Metode penyimpanan activation secara selektif dapat mengurangi kebutuhan VRAM dengan menukar sebagian penggunaan memory dengan komputasi tambahan. Strategi seperti ini berguna ketika kapasitas memory menjadi kendala utama, meski efisiensi memory terkadang harus dibayar dengan proses yang sedikit lebih lambat.
Monitoring Menjadi Bagian Penting dalam Optimasi AI
Optimalisasi GPU tidak hanya dilakukan melalui hardware, melainkan turut ditentukan oleh perangkat lunak, driver, library komputasi, serta framework. Versi driver dan framework yang sesuai dapat membantu memanfaatkan fitur akselerasi GPU. Sebaliknya, konfigurasi yang tidak kompatibel dapat menyebabkan performa tidak maksimal.
Monitoring juga perlu dilakukan selama workload berjalan supaya sumber masalah dapat diidentifikasi secara lebih akurat. Apabila GPU tidak terpakai penuh tetapi CPU mengalami beban besar, hambatan dapat berasal dari proses penyiapan data. Jika GPU bekerja tinggi tetapi VRAM selalu penuh, pengaturan batch, format numerik, alokasi memory, serta model perlu dievaluasi. Pendekatan berbasis pengukuran lebih efektif dibandingkan sekadar menebak konfigurasi terbaik.
Penutup
Meningkatkan efisiensi GPU AI pada 2026 bukan sekadar mengejar utilisasi tinggi tetapi juga mengatur memory dan workload secara tepat. Pengelolaan VRAM, penyesuaian batch size, penggunaan mixed precision, quantization, serta monitoring performa berpotensi meningkatkan efisiensi tanpa harus langsung mengganti hardware. Setiap model memiliki kebutuhan berbeda, sehingga pengujian konfigurasi secara bertahap tetap menjadi langkah yang penting.
Perkembangan TEKNOLOGI AI yang semakin cepat mendorong pengguna untuk lebih memahami cara memanfaatkan perangkat secara efisien. GPU dengan kapasitas besar memang memberikan ruang lebih luas, tetapi konfigurasi yang tepat tetap dapat memberikan perbedaan besar pada hardware yang tersedia. Dengan mempelajari keterkaitan VRAM, ukuran batch, format numerik, serta karakter workload, pengguna dapat membangun workflow AI yang lebih cepat, stabil, dan efisien. Pengguna dapat menguji beberapa konfigurasi kemudian membandingkan penggunaan VRAM serta kecepatannya untuk mendapatkan pengaturan terbaik.