Tips Mengoptimalkan GPU untuk AI di 2026, Atur Memory hingga Batch Size agar Lebih Efisien
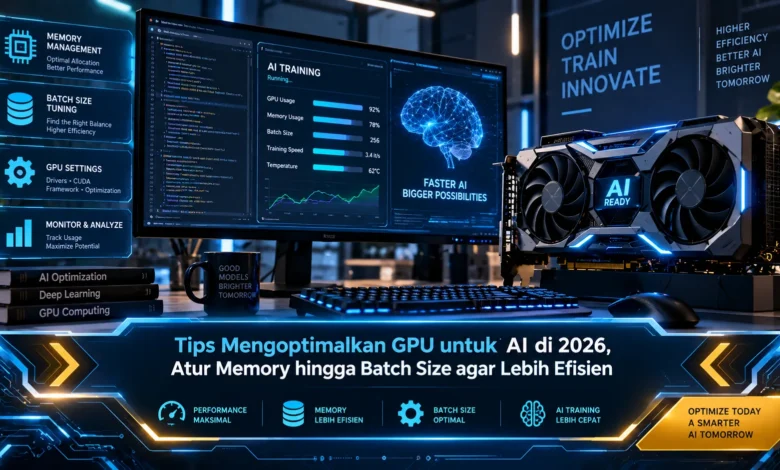
Penggunaan GPU untuk menjalankan workload AI pada 2026 semakin beragam, mulai dari inference model lokal, generative AI, hingga training dan fine tuning. Namun, GPU yang cepat belum tentu memberikan hasil optimal jika VRAM, batch size, precision, dan alokasi memory tidak dikonfigurasi dengan tepat. Dalam perkembangan TEKNOLOGI AI yang semakin intensif terhadap komputasi, memahami cara mengoptimalkan sumber daya GPU menjadi langkah penting agar performa tetap tinggi tanpa memboroskan kapasitas perangkat.
Kenali Kebutuhan GPU dan VRAM Sebelum Menjalankan AI
Tahap awal untuk meningkatkan efisiensi GPU pada workload AI adalah memahami kebutuhan model yang akan digunakan. Setiap model AI memiliki kebutuhan komputasi dan memory yang berbeda, sehingga konfigurasi GPU sebaiknya disesuaikan dengan jenis pekerjaan yang dijalankan. Model berukuran besar cenderung memberikan tekanan lebih tinggi terhadap memori grafis dibandingkan model yang lebih ringan.
Penting pula memahami perbedaan penggunaan GPU untuk training maupun inference. Pelatihan model cenderung mengonsumsi memory lebih tinggi karena harus menyimpan berbagai data sementara selama komputasi, sedangkan inference umumnya memiliki kebutuhan memory yang lebih sederhana. Dengan memahami perbedaan tersebut, pengaturan TEKNOLOGI AI dapat dilakukan tanpa membebani hardware secara berlebihan.
Atur Memory GPU agar VRAM Tidak Cepat Penuh
Pengelolaan memory GPU merupakan faktor utama dalam menjaga performa workload AI. Kapasitas VRAM tidak hanya dikonsumsi oleh ukuran model, melainkan digunakan pula untuk activation, buffer, cache, dan tensor yang sedang diproses. Dengan demikian, menggunakan hampir seluruh memory hanya untuk model dapat membuat workload kekurangan ruang saat komputasi dimulai.
Cara yang cukup praktis adalah mempertahankan sebagian kapasitas VRAM agar tetap tersedia. Pemakaian VRAM sebaiknya diperiksa ketika model sedang digunakan untuk mengetahui bagian yang paling banyak menghabiskan sumber daya. Jika terdapat aplikasi lain yang menggunakan GPU, menonaktifkan program yang tidak dibutuhkan bisa meningkatkan kapasitas memory yang tersedia sehingga TEKNOLOGI AI dapat berjalan dengan penggunaan sumber daya yang lebih terkendali.
Atur Ukuran Batch agar Performa dan VRAM Tetap Seimbang
Batch size memiliki pengaruh langsung terhadap kapasitas memory serta efisiensi komputasi GPU. Batch yang semakin besar biasanya membutuhkan VRAM lebih banyak, walaupun dapat membantu GPU memproses lebih banyak data secara bersamaan. Sebaliknya, ukuran batch yang sangat rendah berpotensi membuat sebagian kemampuan komputasi GPU tidak terpakai.
Strategi yang lebih seimbang ialah menguji beberapa ukuran batch sembari memperhatikan konsumsi memory. Ketika penggunaan VRAM mulai mendekati batas aman, pengguna dapat memilih ukuran batch sebelumnya sebagai konfigurasi yang lebih stabil. Apabila kapasitas GPU tidak memungkinkan penggunaan batch besar, pengguna dapat memanfaatkan akumulasi gradient dalam beberapa iterasi agar proses training dapat menyerupai penggunaan batch lebih besar tanpa membutuhkan seluruh VRAM sekaligus.
FP16 dan BF16 Bisa Membantu Mengurangi Beban VRAM
Precision menjadi faktor penting dalam mengatur efisiensi workload kecerdasan buatan. Menjalankan setiap komputasi menggunakan format numerik berpresisi tinggi bisa membuat konsumsi VRAM menjadi lebih besar meskipun beberapa proses dapat menggunakan representasi numerik yang lebih hemat. Karena itu, mixed precision menjadi salah satu strategi populer dalam workload AI.
Format seperti FP16 atau BF16 dapat membantu menghemat memory ketika dibandingkan dengan precision penuh pada setiap operasi. Ketika kartu grafis memiliki dukungan komputasi yang sesuai, throughput dapat bertambah karena GPU mampu menjalankan komputasi dengan lebih efektif. Meski demikian, pengguna tetap perlu memastikan model dan framework mendukung precision yang digunakan supaya efisiensi tidak mengorbankan stabilitas proses.
Manfaatkan Quantization dan Teknik Penghemat Memory
Pengurangan precision pada bobot model dapat menjadi strategi efektif saat pengguna ingin menjalankan model yang lebih besar pada GPU terbatas. Teknik ini mengurangi precision representasi parameter, sehingga kebutuhan kapasitas memori grafis menjadi lebih rendah. Format 8 bit maupun 4 bit berpotensi membuat model yang sebelumnya terlalu berat menjadi lebih mudah dimuat.
Tidak hanya melalui pengurangan precision model, pengguna dapat memanfaatkan checkpointing atau strategi pemindahan sebagian workload ke memory sistem jika framework mendukungnya. Teknik checkpointing activation dapat membantu menghemat VRAM melalui proses recomputation pada tahapan tertentu. Teknik penghematan tersebut berguna ketika kapasitas memory menjadi kendala utama, meski efisiensi memory terkadang harus dibayar dengan proses yang sedikit lebih lambat.
Optimalkan Framework dan Pantau Bottleneck GPU
Performa AI tidak hanya ditentukan oleh kekuatan kartu grafis, namun juga bergantung pada lingkungan software yang menjalankan workload. Versi driver dan framework yang sesuai dapat membuka akses terhadap kemampuan komputasi yang tersedia pada perangkat. Di sisi lain, ketidaksesuaian software dapat membuat sebagian kemampuan GPU tidak termanfaatkan.
Pengguna perlu mengamati kondisi GPU saat AI dijalankan untuk mengetahui komponen yang membatasi performa. Jika utilisasi GPU rendah sementara CPU bekerja sangat tinggi, bottleneck kemungkinan terjadi sebelum data mencapai GPU. Apabila utilisasi kartu grafis maksimal bersamaan dengan penggunaan memory yang sangat tinggi, pengaturan batch, format numerik, alokasi memory, serta model perlu dievaluasi. Strategi yang mengandalkan data performa dapat membantu mendapatkan konfigurasi TEKNOLOGI AI yang benar benar sesuai dengan perangkat.
Penutup
Optimalisasi GPU untuk workload AI pada 2026 memerlukan keseimbangan antara kecepatan komputasi, penggunaan VRAM, serta kebutuhan model. Pengaturan VRAM, pemilihan batch, penggunaan precision campuran, optimasi model, serta evaluasi bottleneck mampu membuat sumber daya GPU dimanfaatkan secara lebih optimal. Setiap jenis proses AI memiliki pola penggunaan sumber daya yang tidak sama, sehingga konfigurasi terbaik sebaiknya ditemukan melalui pengukuran langsung.
Perkembangan TEKNOLOGI AI yang semakin cepat mendorong pengguna untuk lebih memahami cara memanfaatkan perangkat secara efisien. Kartu grafis dengan VRAM tinggi tentu menawarkan fleksibilitas lebih baik, tetapi konfigurasi yang tepat tetap dapat memberikan perbedaan besar pada hardware yang tersedia. Dengan mempelajari keterkaitan VRAM, ukuran batch, format numerik, serta karakter workload, pengguna dapat membangun workflow AI yang lebih cepat, stabil, dan efisien. Pembaca dapat melakukan pengujian terukur pada workload yang digunakan agar kombinasi performa, stabilitas, dan efisiensi dapat ditemukan secara lebih akurat.