Tips Mengoptimalkan GPU untuk AI di 2026, Atur Memory hingga Batch Size agar Lebih Efisien
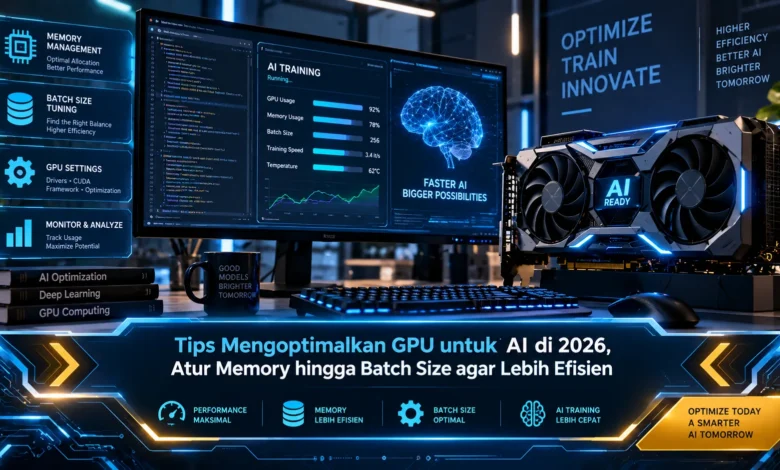
Penggunaan GPU untuk menjalankan workload AI pada 2026 semakin beragam, mulai dari inference model lokal, generative AI, hingga training dan fine tuning. Namun, GPU yang cepat belum tentu memberikan hasil optimal jika VRAM, batch size, precision, dan alokasi memory tidak dikonfigurasi dengan tepat. Dalam perkembangan TEKNOLOGI AI yang semakin intensif terhadap komputasi, memahami cara mengoptimalkan sumber daya GPU menjadi langkah penting agar performa tetap tinggi tanpa memboroskan kapasitas perangkat.
Kenali Kebutuhan GPU dan VRAM Sebelum Menjalankan AI
Langkah pertama dalam mengoptimalkan GPU untuk AI ialah mengenali karakteristik workload yang hendak dijalankan. Setiap workload kecerdasan buatan memiliki karakteristik penggunaan GPU yang berbeda, sehingga konfigurasi GPU sebaiknya disesuaikan dengan jenis pekerjaan yang dijalankan. Arsitektur AI yang lebih kompleks cenderung memberikan tekanan lebih tinggi terhadap memori grafis daripada model dengan jumlah parameter lebih kecil.
Penting pula memahami perbedaan penggunaan GPU untuk training maupun inference. Pelatihan model cenderung mengonsumsi memory lebih tinggi karena harus menyimpan berbagai data sementara selama komputasi, sedangkan inference umumnya memiliki kebutuhan memory yang lebih sederhana. Dengan mengenali karakter workload, pengguna dapat menentukan strategi optimasi yang lebih tepat.
Manajemen VRAM Menjadi Kunci Optimasi GPU AI
Pengaturan kapasitas memori grafis memiliki peranan besar dalam menentukan stabilitas proses komputasi. VRAM tidak hanya digunakan untuk menyimpan bobot model, tetapi juga dipakai untuk activation, cache, tensor sementara, serta berbagai operasi komputasi. Karena itu, memuat model yang hampir memenuhi seluruh kapasitas VRAM dapat menimbulkan masalah ketika proses berjalan.
Pendekatan yang bisa digunakan adalah mempertahankan sebagian kapasitas VRAM agar tetap tersedia. Pengguna juga dapat memantau konsumsi memory selama workload berjalan agar dapat ditemukan tahapan yang menyebabkan konsumsi memory melonjak. Jika terdapat aplikasi lain yang menggunakan GPU, menonaktifkan program yang tidak dibutuhkan bisa meningkatkan kapasitas memory yang tersedia sehingga TEKNOLOGI AI dapat berjalan dengan penggunaan sumber daya yang lebih terkendali.
Batch Size yang Tepat Membantu Menjaga Efisiensi
Pengaturan jumlah data per batch sangat berpengaruh terhadap kapasitas memory serta efisiensi komputasi GPU. Ukuran batch yang lebih tinggi umumnya meningkatkan konsumsi memory GPU, meskipun pada kondisi tertentu dapat meningkatkan pemanfaatan GPU. Sementara itu, batch kecil dapat mengurangi efisiensi apabila GPU sebenarnya masih memiliki banyak sumber daya yang tersedia.
Pendekatan yang lebih efektif adalah menyesuaikan batch secara perlahan berdasarkan kapasitas GPU. Saat memory GPU mulai terpakai dalam jumlah tinggi, pengaturan dapat diturunkan sedikit untuk menjaga margin memory. Jika batch kecil diperlukan karena keterbatasan VRAM, pengguna dapat memanfaatkan akumulasi gradient dalam beberapa iterasi sehingga kebutuhan memory per langkah tetap lebih rendah tanpa kehilangan manfaat akumulasi batch.
FP16 dan BF16 Bisa Membantu Mengurangi Beban VRAM
Precision menjadi faktor penting dalam menentukan penggunaan memory dan performa GPU. Memproses semua operasi dengan precision yang lebih berat bisa membuat konsumsi VRAM menjadi lebih besar padahal workload tertentu dapat memanfaatkan precision yang lebih rendah. Oleh sebab itu, mixed precision dapat digunakan sebagai salah satu metode meningkatkan efisiensi komputasi.
Format seperti FP16 atau BF16 berpotensi menekan konsumsi VRAM dibandingkan menjalankan seluruh komputasi dalam FP32. Pada hardware modern yang dioptimalkan untuk precision tersebut, throughput dapat bertambah karena GPU mampu menjalankan komputasi dengan lebih efektif. Meski demikian, pengguna tetap perlu memastikan model dan framework mendukung precision yang digunakan sehingga penggunaan TEKNOLOGI tersebut tetap memberikan hasil yang sesuai.
Manfaatkan Quantization dan Teknik Penghemat Memory
Pengurangan precision pada bobot model dapat menjadi strategi efektif apabila keterbatasan memory menghambat penggunaan model. Pendekatan quantization menurunkan jumlah bit yang digunakan untuk merepresentasikan parameter, sehingga ukuran model di memory dapat berkurang. Format 8 bit maupun 4 bit sering dimanfaatkan untuk membuat inference model besar lebih ringan.
Selain quantization, teknik checkpointing maupun offloading dapat digunakan sesuai dukungan software yang tersedia. Teknik checkpointing activation dapat membantu menghemat VRAM melalui proses recomputation pada tahapan tertentu. Pendekatan tersebut cukup membantu untuk GPU dengan VRAM terbatas, meskipun pengguna perlu mempertimbangkan dampaknya terhadap kecepatan.
Software yang Tepat Membantu GPU Bekerja Maksimal
Meningkatkan efisiensi GPU tidak semata bergantung pada spesifikasi perangkat, namun juga bergantung pada lingkungan software yang menjalankan workload. Lingkungan perangkat lunak yang telah dikonfigurasi secara tepat dapat membantu memanfaatkan fitur akselerasi GPU. Sebaliknya, konfigurasi yang tidak kompatibel dapat menyebabkan performa tidak maksimal.
Pengguna perlu mengamati kondisi GPU saat AI dijalankan supaya sumber masalah dapat diidentifikasi secara lebih akurat. Ketika penggunaan GPU kecil sedangkan prosesor berada pada tingkat utilisasi tinggi, masalah mungkin berada pada pipeline data atau preprocessing. Apabila utilisasi kartu grafis maksimal bersamaan dengan penggunaan memory yang sangat tinggi, pengaturan batch, format numerik, alokasi memory, serta model perlu dievaluasi. Pendekatan berbasis pengukuran lebih efektif dibandingkan sekadar menebak konfigurasi terbaik.
Penutup
Optimalisasi GPU untuk workload AI pada 2026 memerlukan keseimbangan antara kecepatan komputasi, penggunaan VRAM, serta kebutuhan model. Pengelolaan VRAM, penyesuaian batch size, penggunaan mixed precision, quantization, serta monitoring performa mampu membuat sumber daya GPU dimanfaatkan secara lebih optimal. Setiap jenis proses AI memiliki pola penggunaan sumber daya yang tidak sama, karena itu eksperimen terhadap beberapa pengaturan tetap diperlukan.
Kemajuan TEKNOLOGI kecerdasan buatan yang terus berlangsung mendorong pengguna untuk lebih memahami cara memanfaatkan perangkat secara efisien. Perangkat dengan memory besar dapat mempermudah penggunaan model kompleks, meski demikian optimasi tetap diperlukan agar sumber daya tidak terbuang. Dengan mempelajari keterkaitan VRAM, ukuran batch, format numerik, serta karakter workload, pengguna dapat membangun workflow AI yang lebih cepat, stabil, dan efisien. Pengguna dapat menguji beberapa konfigurasi kemudian membandingkan penggunaan VRAM serta kecepatannya untuk mendapatkan pengaturan terbaik.